新闻
Mistral Large 4 登上 Hacker News:欧洲大模型还能守住阵地吗
Mistral 发布新一代旗舰模型 Large 4,在 Hacker News 引发近三百点讨论。在开源与闭源边界日益模糊的当下,这家欧洲最具代表性的模型公司需要回答一个更现实的问题:它靠什么继续留在牌桌上。
Hacker News2 分钟阅读
来自全网的最新 AI 资讯,每日自动聚合更新
共 567 篇
Mistral 发布新一代旗舰模型 Large 4,在 Hacker News 引发近三百点讨论。在开源与闭源边界日益模糊的当下,这家欧洲最具代表性的模型公司需要回答一个更现实的问题:它靠什么继续留在牌桌上。
Mistral 推出万亿参数级新模型 Le Chonk,主打开放权重,并宣称是中国以外最强的开源模型,意在证明自己仍在前沿 AI 竞赛之中。
Reflection 推出首个开放权重模型 Beam,5010 亿参数中每 token 仅激活 230 亿,主打以三到四倍更少的算力在编码与推理上对标 GLM 5.2。
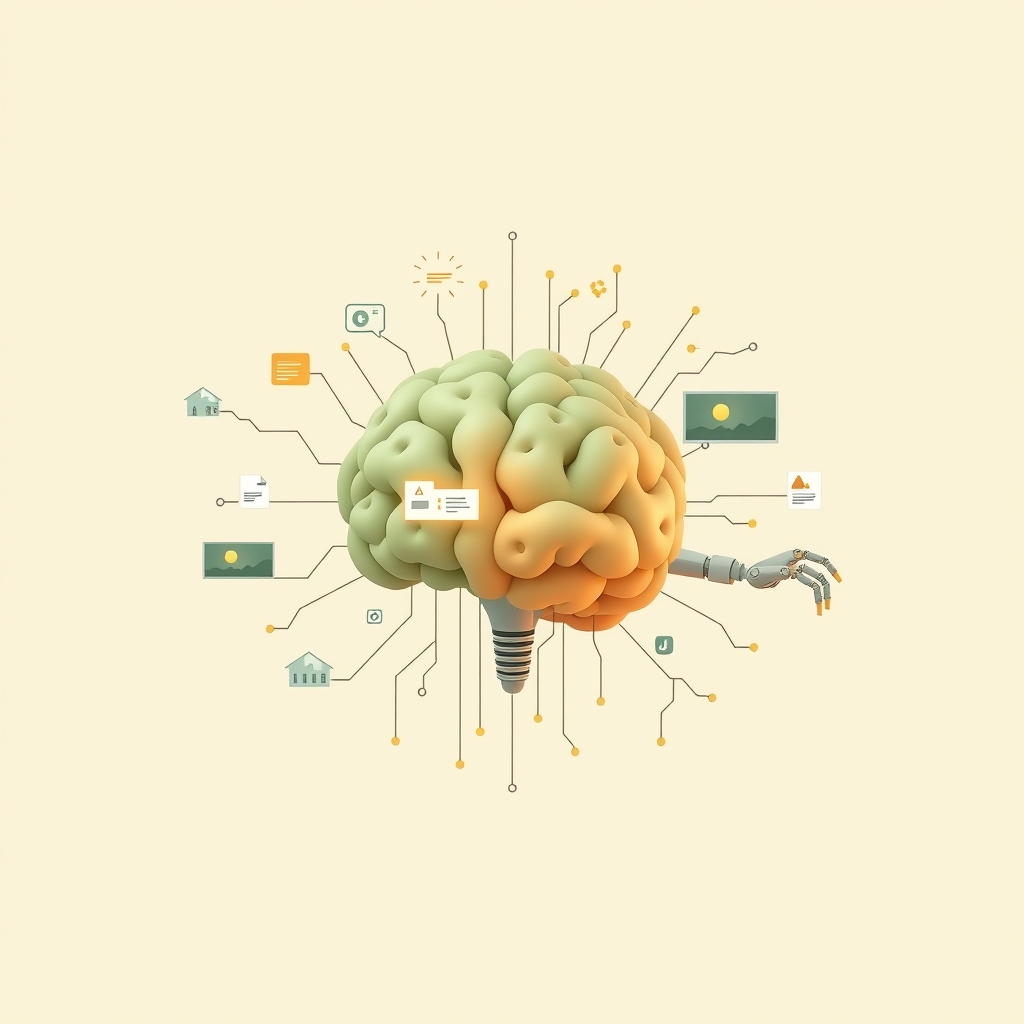
Reka 推出 Rho-1,一个从零训练的 19B 全能推理模型,能在共享 KV 缓存上读写文本、图像、视频并输出机器人动作;蒸馏版生成 5.3 秒视频仅需约一秒,目前为研究预览,未公开权重。
Hugging Face 上出现面向阿联酋阿拉伯语方言的 Falcon-Emirati 模型,指向一个被主流大模型长期忽视的问题:方言、文化语境与本地语感,才是语言覆盖的真正难点。
MarkTechPost 介绍了一套基于 NVIDIA Cosmos3-DROID 的端到端流式机器人学习管线,通过 byte-range Parquet 读取、行为克隆与时间集成,实现无需本地下载数据集的训练流程。
Reflection AI 推出首个开放权重模型 Beam,501B 稀疏 MoE、23B 激活参数,面向编程与 Agent 负载,宣称在推理任务上以 3-4 倍更少的推理算力对标 GLM-5.2,Apache 2.0 权重预计 2026 年 10 月晚些时候放出。
Reflection AI 推出首个开放权重模型 Beam,声称在推理能力上对标 GLM-5.2,且推理算力消耗显著更低,权重将于本月开放。
Reflection 推出名为 Beam 的 501B 参数开源权重模型,在 Hacker News 引发热议。这标志着开源大模型参数规模继续向千亿级以上攀升,也把“开源权重”与“闭源前沿”的边界问题再次推到台前。
Reka AI 发布 190 亿参数的 omni-model Rho-1,把文本、图像、视频和机器人控制动作统一为同一上下文窗口中的 token,用远低于头部模型的算力完成训练。
德国 Aleph Alpha 发布 78B 参数的德英混合专家模型 Kolibri,每 token 仅激活约 3B 参数,训练全程使用德国与芬兰的 768 张 B200,权重以 Apache 2.0 开放。
MarkTechPost 梳理了 Qwen 从 2023 年 4 月的邀请制聊天机器人到 2.4 万亿参数开源权重模型的完整发布脉络,逐版本记录核心特性与许可证变化。这条曲线既是阿里的大模型投入史,也是开源权重阵营扩张的缩影。