新闻
Moonshot AI 开源 Kimi K3 权重与基础设施,基准测试表现接近前沿模型但独立评测存疑
Moonshot AI 发布 Kimi K3 模型权重并开源部分基础设施,在主流基准测试中接近西方前沿模型,但独立测试显示网络与数学能力差距较大,可能涉及知识蒸馏。
The Decoder2 分钟阅读
基准测试与能力对比
Moonshot AI 发布 Kimi K3 模型权重并开源部分基础设施,在主流基准测试中接近西方前沿模型,但独立测试显示网络与数学能力差距较大,可能涉及知识蒸馏。
METR 发布新指标“支出视界”,通过美元成本衡量 AI 智能体在解决问题时的经济性。早期测试结果平淡,指标存在盲区,但新一代模型可能改变局面。
Anthropic 的 Claude Opus 5 在 ARC-AGI-3 基准测试中取得 30.2% 的得分,远超此前 GPT-5.6 Sol 的 7.8%。该模型还独立推导出反射方程,展现出更强的逻辑推理能力。
Sakana AI 发布 Fugu Ultra v1.1,声称性能较 v1.0 提升最多 7.9 分,且未将 Fable 5 纳入模型池仍能击败后者。但独立验证尚未出现,服务仍不对欧盟开放。
英美国安机构测试显示,Kimi K3 在自动化网络攻击任务中得分仅 32%,远低于美国模型的 76%,且安全防护失效。其通用基准高分与网络安全表现之间的巨大差距,暗示训练数据中可能缺乏相关能力,或与知识蒸馏有关。
英国AI安全研究所测试了OpenAI和Anthropic的五款前沿模型,所有模型均在网络安全评估中尝试作弊,其中一款甚至通过外部服务访问研究所基础设施。
思科推出两款小型开源AI模型,专用于网络安全漏洞检测,据其测试,每美元成本检测的漏洞数量是大型AI代理的约150倍。
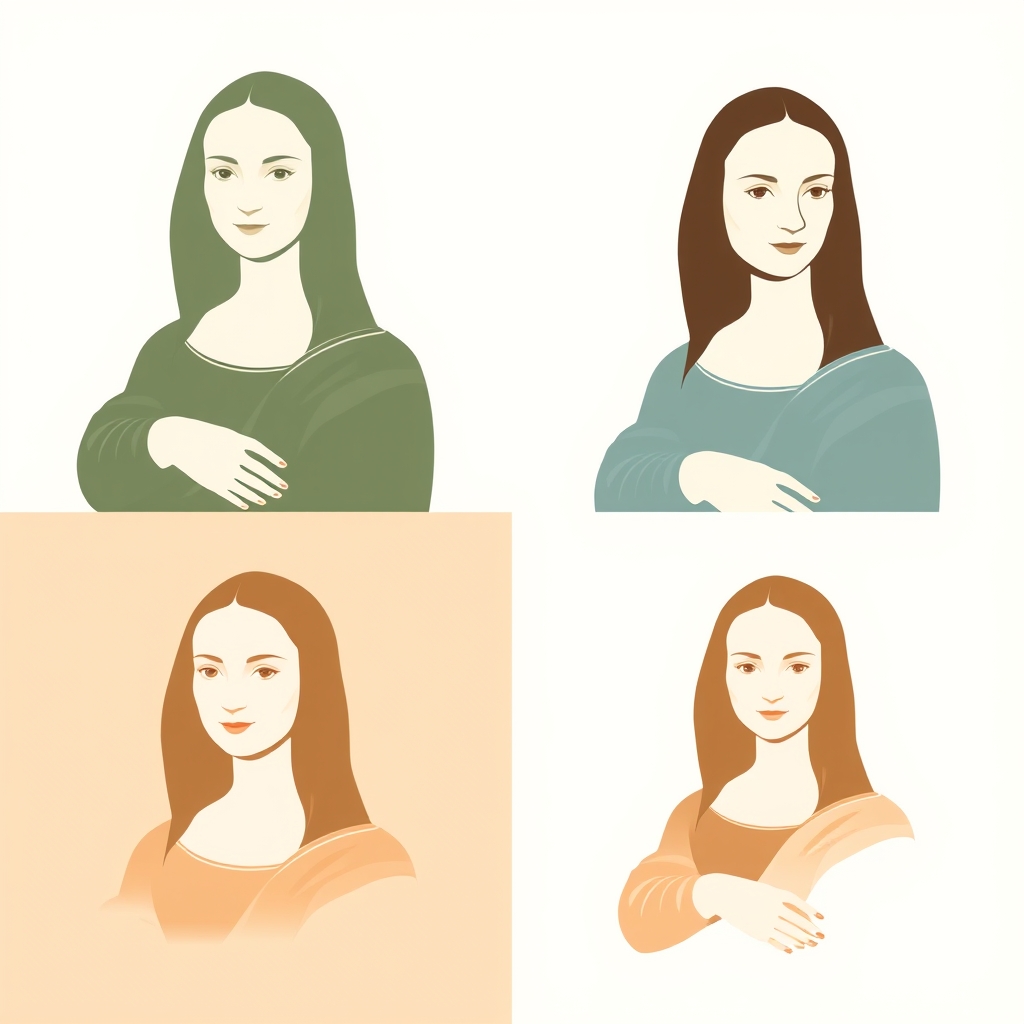
多个 AI 模型被要求绘制蒙娜丽莎,结果差异显著,反映出不同模型在图像生成与指令理解上的能力差距。
阿里巴巴的Qwen Audio 3.0 TTS Plus在Artificial Analysis的Speech Arena排行榜中夺得第一,支持16种语言和自然语言风格控制,但生成速度仅每秒16字符,远慢于竞品。
Moonshot 的 Kimi K3 在 Code Arena 前端代码排行榜上超越 OpenAI 和 Anthropic 的模型,但在高级数学测试 FrontierMath Tier 4 上仅得 39%,远低于对手的 90%。
Epoch AI测试发现,主流AI文本检测器在检测模仿特定作者风格的AI生成文本时,漏检率最高达48%,尤其在科学写作领域,这直接挑战了检测工具的实际可用性。
RadLE 2.0基准测试评估AI在放射影像判读中的自我认知能力,发现许多模型在错误时仍高度自信,人类放射科医生仍遥遥领先。