小米机器人团队的最新研究揭示了一个重要趋势:在机器人运动训练中,更多的数据比更大的模型更有效。
发生了什么
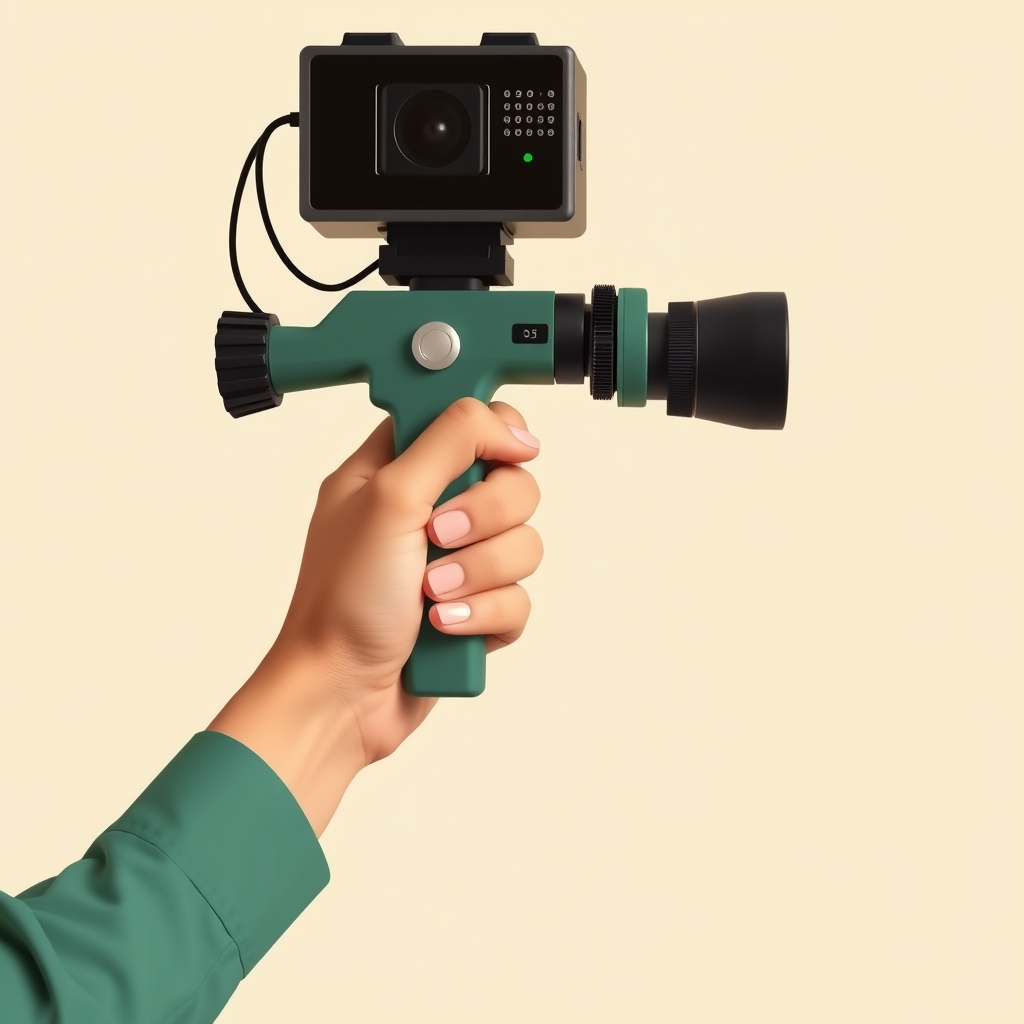
小米训练了名为 Xiaomi-Robotics-1 的机器人模型,使用了超过 10 万小时的运动数据。这些数据并非来自机器人本身,而是由人类使用配备摄像头的手持夹具收集的。实验结果表明,增加数据量对机器人运动性能的提升,远远超过增加模型规模所带来的收益。而且,这种提升尚未出现平台期,意味着继续增加数据可能带来更多进步。不过,目前的绝对成功率仍然较低。
为什么重要
这一发现挑战了近年来 AI 领域“越大越好”的主流观念。在自然语言处理和计算机视觉领域,扩大模型规模一直是提升性能的主要手段。然而,在机器人运动控制这一物理交互任务中,数据的多样性和覆盖范围可能比模型容量更为关键。人类通过手持夹具收集数据的方式,成本远低于使用真实机器人,且能更灵活地采集各种场景下的运动轨迹。这为机器人训练提供了一条更经济、更可扩展的路径。
影响与看点
对于机器人行业而言,这一结果意味着未来研发重点可能从模型架构创新转向数据收集策略优化。开发者或许无需追求超大模型,而是应投入资源构建更丰富、更高质量的运动数据集。对于小米这样的消费电子公司,低成本数据采集方法可能加速其在家庭服务机器人等领域的落地。值得关注的是,绝对成功率低说明单纯增加数据仍有瓶颈,未来可能需要结合更好的算法或仿真环境。独立判断:在机器人运动领域,数据规模的红利可能比模型规模更大,但最终仍需算法突破来提升上限。