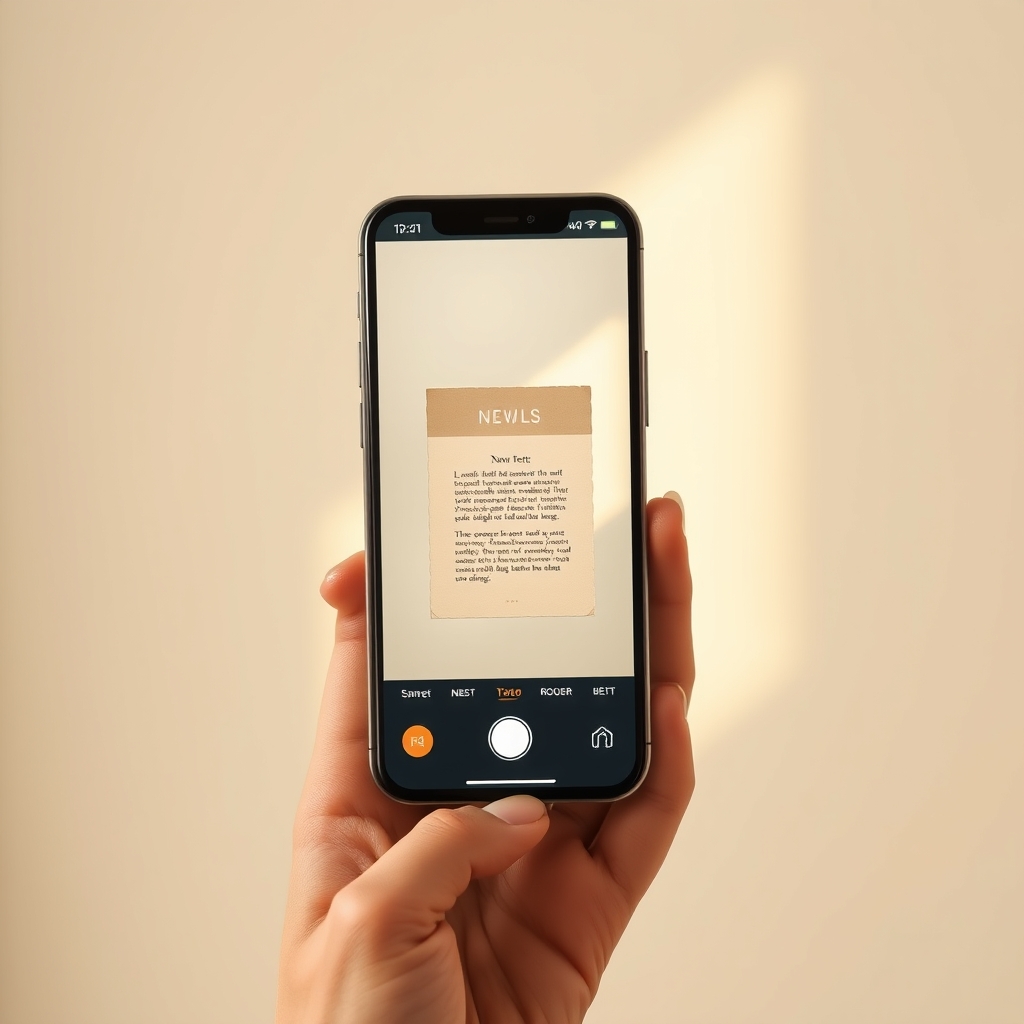
把摄像头对准说明书上的小字,AI 直接念给你听——Google 正在把多模态能力从"问答"推向"实时陪伴"。
发生了什么
据 The Verge 报道,Google 在 Gemini Live 中推出了一项名为 Guided Vision 的新功能,即日起在兼容的 Android 设备上线。用户可以在 Gemini Live 中共享手机摄像头画面,让 AI 以实时语音的方式描述镜头所指向的内容。官方给出的典型场景包括:读取过小的文字、描述周围环境、寻找或识别视野中的物体。
值得注意的是,这项功能被放在 Gemini Live 里,而不是独立的相机应用或搜索入口。这意味着它的交互形态是"持续对话"而非"单次识别":用户不需要反复拍照、上传、等待结果,而是保持一段开放的语音会话,让 AI 边看边说。
为什么重要
实时视觉 + 语音,是过去一年大模型产品竞争最集中的方向之一。摄像头是手机最普及的传感器,但长期以来它只服务于"记录",而不是"理解"。Guided Vision 试图改变的是这个默认设定:摄像头从取景工具变成信息输入通道,AI 从被动应答者变成随行的解说者。
从 Google 的产品逻辑看,这一步也顺理成章。Gemini Live 此前已经支持实时语音对话,加入视觉等于补齐了另一半感官。相比把多模态能力塞进搜索框或独立 App,把它挂在 Live 会话上,更贴近"随时可用"的助手定位,也更容易形成使用习惯。
另一个容易被忽略的点是受众。读小字、认物体、描述环境,这些描述天然指向视障用户和老年人群体。虽然 Google 并未把 Guided Vision 定位为无障碍功能,但它的能力清单与辅助技术的需求高度重合。这既是产品机会,也意味着一旦体验不稳定,代价会比普通场景更高。
影响与看点
对普通用户来说,最直接的变化是"看不懂的东西可以问"——药品说明、菜单、设备标签、陌生植物或商品,都能通过一段语音会话解决。对开发者而言,更值得关注的是这类能力的接口化程度:如果 Guided Vision 的能力未来通过 API 开放,实时视觉理解会成为一批应用的基础组件,而不是某一家助手的专属卖点。
竞争层面,实时视觉正在成为头部厂商的标配赛道。谁能在延迟、识别准确率和对话自然度上做得更稳,谁就更容易把"举着手机问 AI"变成日常动作。
需要保持克制的地方同样明显:目前公布的信息没有涉及支持的设备范围、语言、隐私处理方式,也没有说明摄像头画面如何被使用和存储。对一项持续开启摄像头的功能来说,这些细节的重要性不亚于功能本身。
一个判断:Guided Vision 真正的门槛不在"能不能看懂",而在"能不能一直看懂且不让人尴尬"——实时视觉的胜负,最终取决于延迟和信任,而不是演示效果。