一句话导语
近日,有用户尝试让 GPT-5.6、Claude、Gemini 和 Grok 等主流 AI 模型绘制蒙娜丽莎,结果揭示了各模型在图像生成与指令遵循上的显著差异。
发生了什么
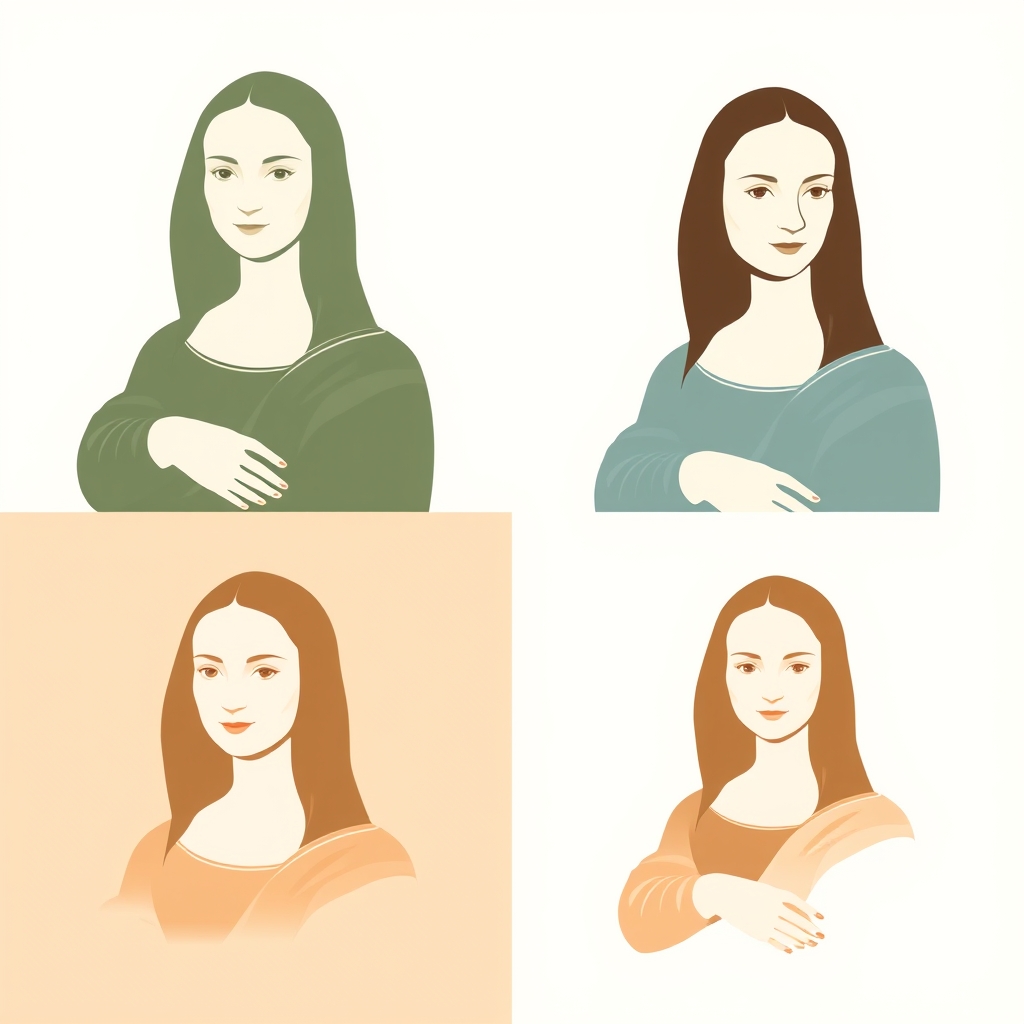
据报道,一位用户向多个 AI 模型发出相同指令:"Drawing the Mona Lisa"。GPT-5.6、Claude、Gemini 和 Grok 分别给出了不同风格的输出。部分模型能够准确理解并生成接近达芬奇原作的图像,而另一些则产生了风格迥异甚至无法识别的结果。这一对比在 Hacker News 上引发了讨论,目前已有 13 个点赞。
为什么重要
这一事件并非简单的趣味测试,而是对当前 AI 模型在图像生成领域能力的一次侧面检验。蒙娜丽莎作为文化符号,其辨识度极高,对模型的细节捕捉、风格模仿和指令理解提出了明确要求。不同模型的表现差异,折射出它们在训练数据、模型架构和优化目标上的不同侧重。例如,某些模型可能在绘画风格迁移上更擅长,而另一些则在忠实还原上表现更好。这为开发者和用户选择模型提供了参考,也凸显了多模态能力评估的复杂性。
影响与看点
对开发者而言,这一对比提示了在特定任务上(如艺术创作、品牌设计)选择模型时需要谨慎。用户可能更关注模型的创意自由度,而企业则可能要求精确性。此外,该事件也引发了对 AI 生成内容版权和原创性的讨论——当模型模仿经典作品时,其产出是否构成侵权?值得关注的是,随着模型能力提升,类似测试将成为评估多模态 AI 的重要基准。独立判断:未来,针对特定文化符号的生成测试可能成为模型评估的标准环节之一。