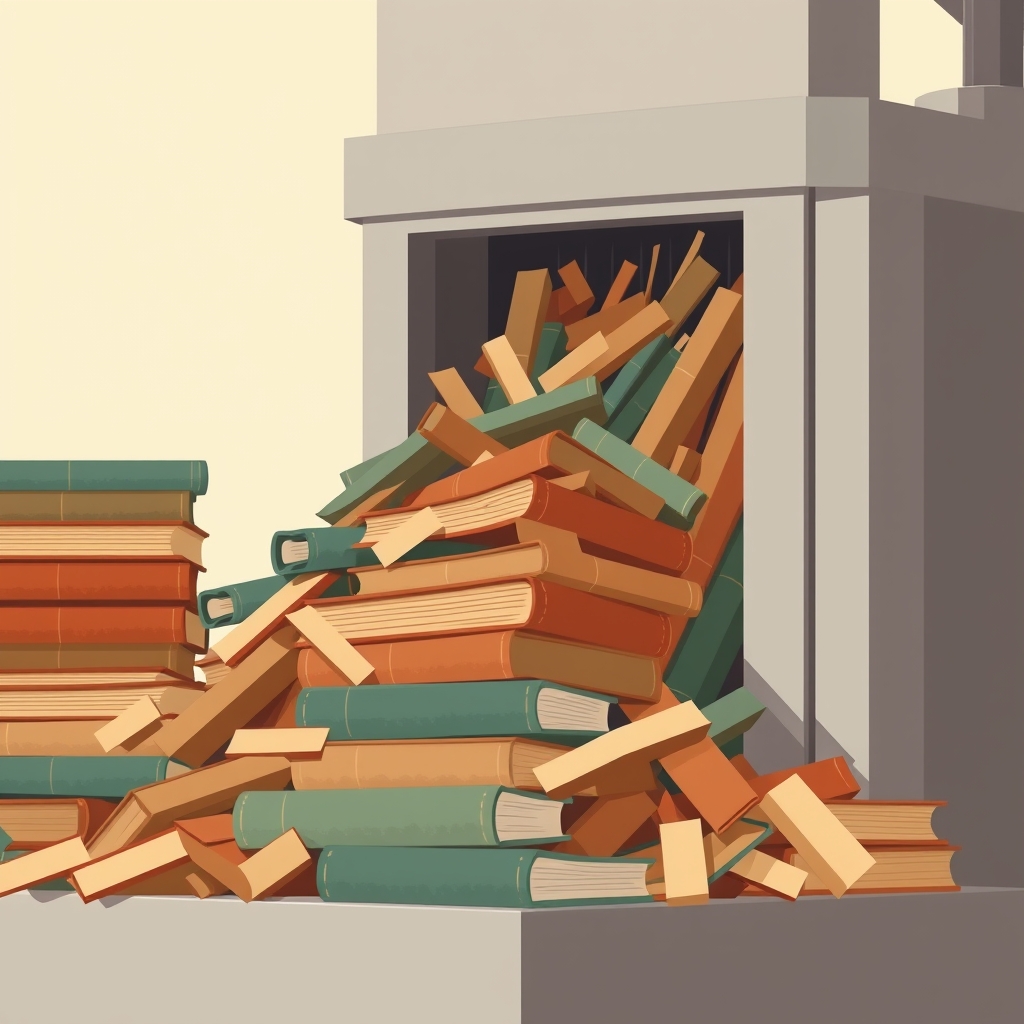
当AI公司为获取高质量训练数据不惜销毁实体书,知识的保存与技术的进步正陷入一场隐秘的冲突。
发生了什么
据Ars Technica报道,部分AI公司正通过中间人批量收购珍稀书籍,甚至包括孤本,随后将其销毁。书商们怀疑这些书籍被用于扫描或提取内容,以训练大语言模型,而销毁行为旨在消除版权痕迹、确保数据独家性。目前已有书商开始拒绝向疑似AI代理的买家出售书籍,并加强了对大宗采购的审查。
为什么重要
这一现象折射出AI训练数据获取的极端化趋势。随着高质量公开文本日益枯竭,科技巨头和初创公司转向图书馆、档案馆和私人收藏,寻求未数字化的稀有文献。然而,直接购买并销毁书籍不仅破坏文化遗产,还可能涉及版权和道德问题。书籍作为人类知识的载体,其物理形态的消失意味着信息保存的不可逆损失,即使内容被数字化,原件的稀缺性和历史价值也无法替代。
影响与看点
对书商和收藏界而言,这迫使行业重新审视销售对象和用途,可能催生更严格的交易规范。对AI开发者来说,这种“数据榨取”策略虽能短期获得独特语料,但长期将面临法律风险和声誉损害。值得关注的是,图书馆和学术机构是否会加强合作,推动合法、透明的数据授权模式。此外,这一事件也凸显了AI发展中的深层矛盾:技术进步是否必然以牺牲文化多样性为代价?未来,平衡数据需求与知识保护,将是整个行业必须面对的课题。


