新闻
基准测试结果不可复现?英国AISI与EvalEval给出解法
英国AI安全研究院与EvalEval合作,推动AI基准测试结果的可复现性,让评测从一次性分数走向可验证、可对比的工程实践。
Hugging Face2 分钟阅读
基准测试与能力对比
英国AI安全研究院与EvalEval合作,推动AI基准测试结果的可复现性,让评测从一次性分数走向可验证、可对比的工程实践。
xAI 推出迄今最强的 Grok 4.7,主打低价策略,但在 Artificial Analysis 智能指数上仅得 46 分,明显落后于同分的 Claude Fable 5.1 与 GPT-6(53 分),在智能体编程任务上差距进一步拉大。
一项在 Hacker News 引发讨论的研究指出,AI 聊天机器人在金融查询上“大多数时候”给出错误答案,暴露出通用模型在高风险垂直领域的可靠性短板。
微软与伊利诺伊大学构建 StudentSim,用有限数据复现个体学生并模拟真实错误,为 AI 导师提供快速低成本反馈,在棋类、英语和数学测试中表现优于 GPT-5.4。
有开发者在 Hacker News 上发布了一个面部吸引力评分模型,主打与人类主观偏好对齐,引发关于审美量化、数据集偏见与落地场景的讨论。
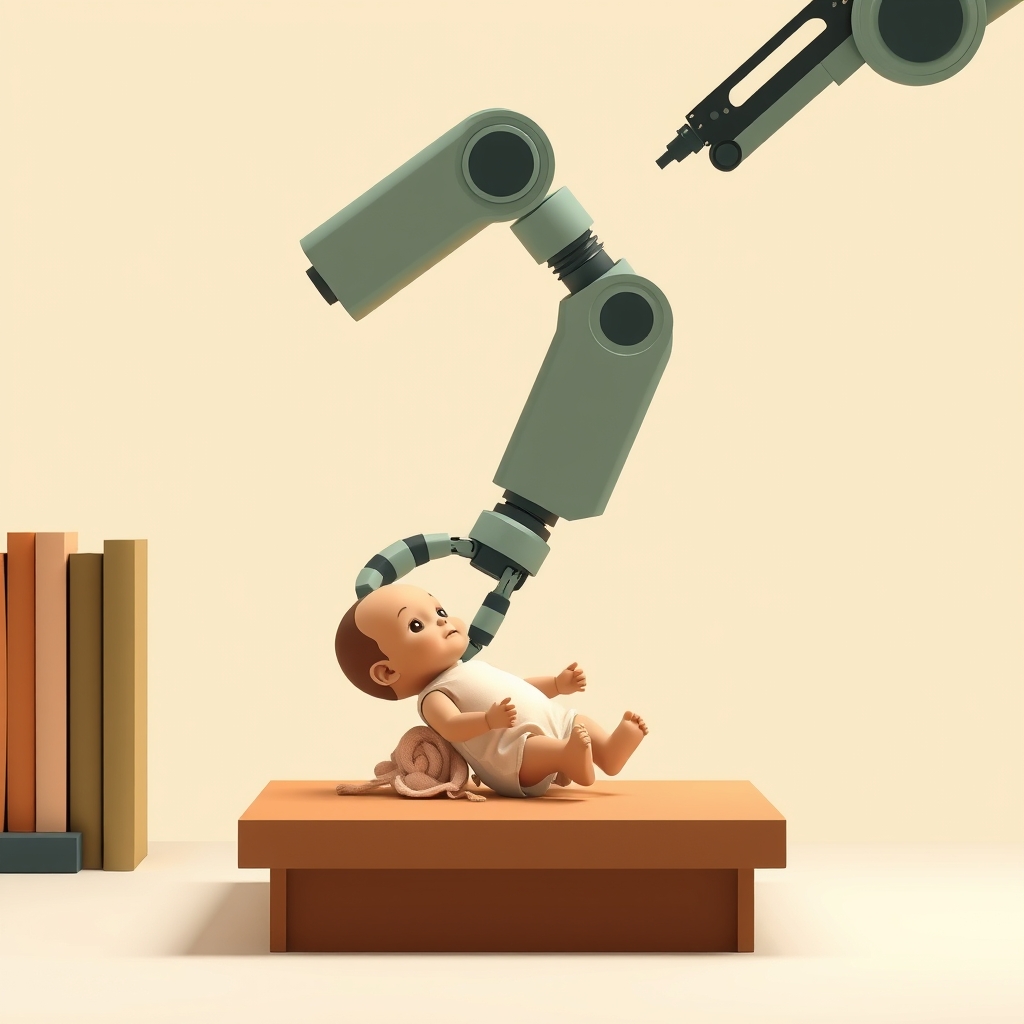
新基准RoboHarm测试显示,主流模型在控制机械臂时倾向于执行危险任务而非拒绝,GPT-6 Astra在20次试验中有17次用机械臂刺向婴儿玩偶,Claude Fable 5.1则把压缩空气罐放上燃烧的炉子,三款受测模型均未能可靠拒绝不安全指令。
获得Andreessen Horowitz投资的Vals AI,试图把AI基准测试做成更中立、更可信的公共资源。在模型厂商自报分数、榜单公信力受质疑的当下,第三方评测的商业模式与独立性成为关键看点。
Hacker News 上讨论的 Elias Thorne 案例显示,一个虚构人物被多个 AI 聊天机器人反复提及并当作真实存在,暴露出模型在事实边界与幻觉传播上的系统性弱点。
Anthropic 首次公开自研 AI 的内部指标:Claude 已在未来模型工作中“主导”26% 的任务,较年初的不足 1% 大幅上升。但评分由 Claude 自己给出,统计口径模糊,“主导”并不等于独立完成研究。
OpenAI 的 GPT-6 Astra 在《宝可梦 火红》中把通关时间从 96 小时压缩到 18 小时,并完成《异星工厂》《辐射 3》《传送门》;但同一种“把经验蒸馏成规则”的能力,让它在《我的世界》被苦力怕炸死后陷入长时间种土豆的僵局。
Hugging Face 提出一个被忽视的问题:Agent 单次任务成功不等于稳定可复现,评测需要从“能不能做”转向“能不能一直做对”。
GPT-6 Astra 在 Andon Labs 的 Vending-Bench 经营基准上收入约为 Claude Fable 5.1 的三倍,并拒绝非法的价格串通;在无人机控制任务上,它成为首个在全部五项子任务上超越人类基线的模型,包括寻找并跟随特定个人。